有害的內容可以迅速發展——無論是由當前的事件推動的,還是由尋找新方法來逃避我們系統的人推動的——而人工智慧系統與之一起發展,至關重要。然而,人工智慧要學會如何去尋找,往往要花上數月的時間,才能收集並標記數以千計,甚至數以百萬計的必需例項,以便讓每一個人工智慧系統都能發現一種新型別的內容。
為了克服這一瓶頸,我們構建和部署了一種名為 Few-Shot Learner(FSL)的新型人工智慧技術,它能夠在數星期之內,而非數個月之內,針對新的或者不斷變化的、有害的內容型別採取行動。它不但可以用於 100 多種語言,還可以從各種資料中學習,比如影象和文字。它可以加強已部署的現有人工智慧模型,從而檢測其他型別的有害內容。
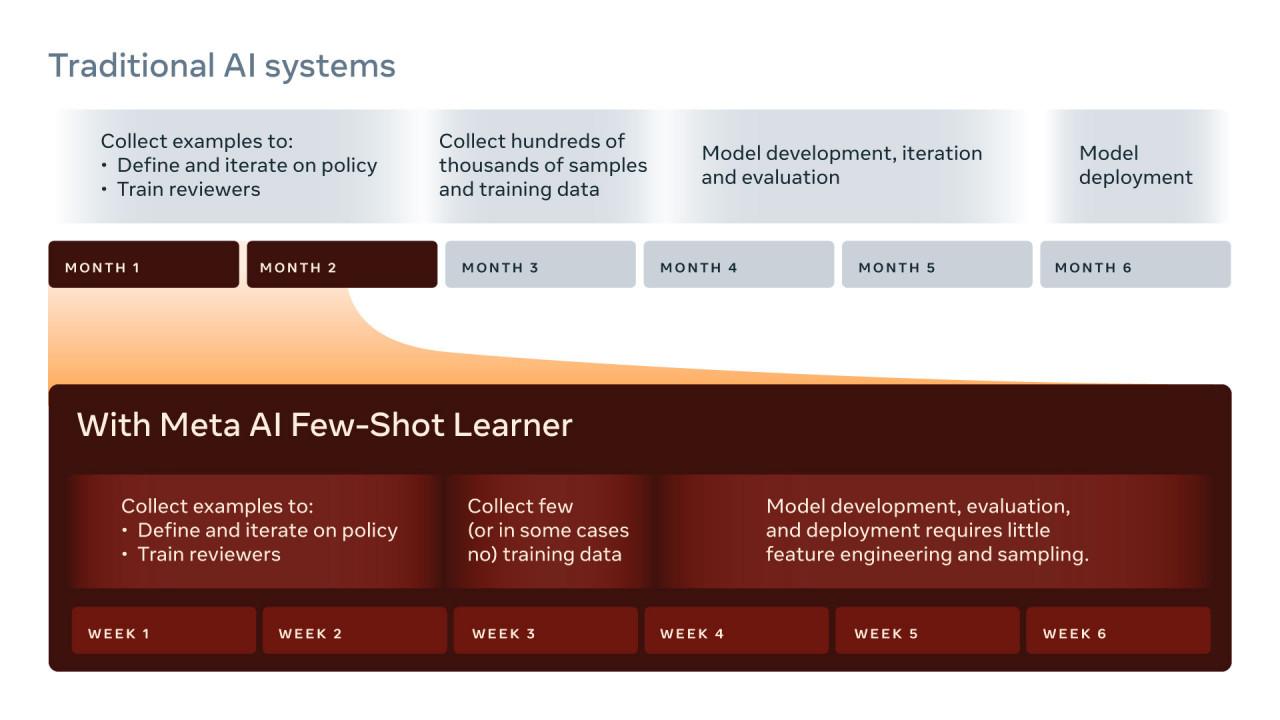
這種新的人工智慧系統使用了一種相對較新的方法,稱為“小樣本學習”(few-shot learning),即模型透過大量的、一般性的理解,再透過少量的、在某些情況下為零的標記樣本,來學習新任務。如果說傳統的系統類似於可以釣上某種魚類的魚線,那麼 FSL 就是一張額外的漁網,可以捕撈其他魚類。
近來的科技突破,例如我們的自監督學習技術以及新型超效率的基礎設施,使得這個領域從傳統的、定製的人工智慧系統轉向更大、更綜合、更通用的系統,減少對標記資料的依賴。首先,它從數以十億計的通用和開源語言樣本上進行訓練。接著,我們用多年來標記的違反策略的內容和邊界內容對人工智慧系統進行了訓練。最後,對解釋新策略的壓縮文字進行了訓練。與以往依靠標記資料進行模式匹配的系統不同,FSL 是基於通用語言以及違反策略和邊界內容語言進行預訓練的,因此它可以隱式地學習策略文字。
我們已經在一些相對較新的事件上測試了 FSL。舉例來說,最近的一項任務就是,識別分享誤導性或聳人聽聞的資訊的內容,其方式很可能會阻止新冠肺炎疫苗的接種(例如,“疫苗或 DNA 改變器?”)。在另一項獨立的任務中,新的人工智慧系統對現有的分類器進行了改進,標記出接近煽動暴力的內容(例如,“那傢伙需要所有的牙齒嗎?”)。傳統的方法可能會漏掉這類煽動性帖子,因為沒有太多標記的樣本使用 DNA 的語言來製造疫苗恐慌,或者引用牙齒來暗示暴力。
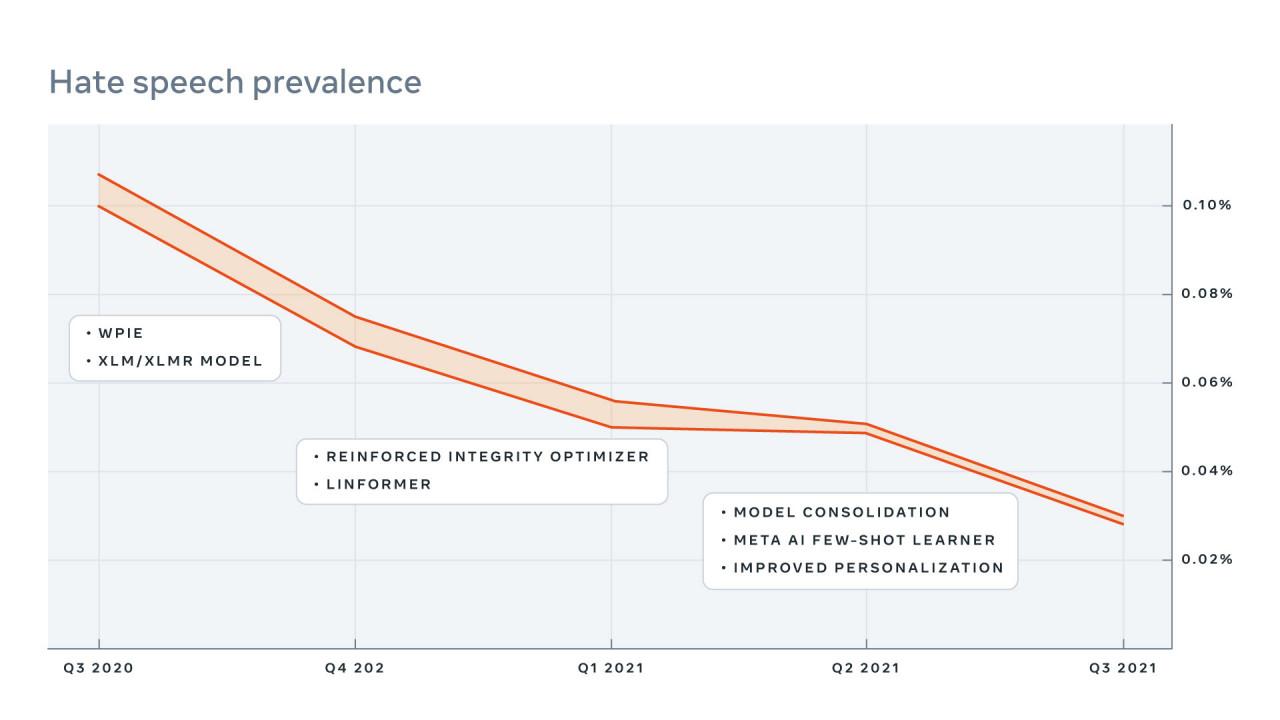
為了測量這個模型的效能,我們制定了一個標準的離線和線上 A/B 測試協議。這些測試中,在 Facebook 和 Instagram 上應用 FSL 前後,我們對有害內容的流行率(即人們看到的違規內容的瀏覽比例)進行了研究。Meta AI Few-shot Learner 可以準確地檢測那些在傳統系統中漏掉的帖子,並且有助於降低這類有害內容的流行。它透過主動檢測潛在的有害內容,從而阻止其在我們的平臺上擴散。我們也發現,FSL 與現有的分類器相結合,有助於降低諸如仇恨言論等其他有害內容的泛濫。
我們還在做更多的實驗,來改善能夠從更多標記的資料中獲益的分類器,例如,在沒有大量標記訓練資料的語言的國家中,我們會繼續對這些新的違反內容模式進行測試。當然,這些都是智慧、通用的人工智慧的雛形。
在人工智慧可以讀懂幾十頁的策略文字,並且立刻就能明確地瞭解它的具體實施方法之前,要實現這一目標,任重而道遠。我們一直在推動人工智慧技術的發展,並儘快進行部署,以更好地服務於我們的社群,我們相信 FSL 將會是一個非常有前途的發展。
引擎蓋下的小樣本學習
Few-Shot Learner 是一個大規模、多模態、多語言、零樣本或小樣本的模型,可以理解聯合策略和內容,可以在不調整模型的情況下,對完整性問題進行概括。我們正在積極開展研究,以訓練使用簡單的策略語句而非數百個有標記的樣本的模型。
我們的新系統在三種不同的場景下工作,每個場景都需要不同級別的標記的樣本:
- 零樣本:沒有樣本的策略描述。
- 有示範的小樣本:有少量樣本的策略描述(少於 50 個)。
- 帶有微調的小樣本:機器學習開發者可以在 FSL 的基礎模型上進行微調,訓練的樣本數量很少。
FSL 的整體投入由三部分組成。首先,在我們以前使用整帖的完整性嵌入(Whole Post Integrity Embeddings,WPIE)的工作基礎上,它從整個帖子中學習多模態資訊,包括文字、影象、URL 等。第二,它分析與策略相關的資訊,如策略的定義,或表明某一特定帖子是否違反該策略定義的有標籤的樣本。第三,如果有的話,我們還採取額外的標記樣本作為示範。
作為我們的新方法的一部分,即所謂的 Entailment Few-Shot Learning,其關鍵思想是將類別標籤轉換成可用於描述標籤的自然語言句子,並確定該例子是否蘊含標籤描述。例如,我們可以重新表述一個明顯的情感分類輸入和標籤對。
[x : “我愛你的種族。JK。你們都應該去死。”y : 積極] 作為下面的文字蘊含樣本:
[x : 我愛你的種族。JK。你們都應該去死。這是仇恨言論。 y : 積極]。
我們將我們提出的方法與目前已有的一些最先進的小樣本學習方法進行了比較。經過一系列的系統評估,我們發現我們的方法比各種最先進的小樣本學習方法高出 55%(平均為 12%)。在這裡:https://arxiv.org/pdf/2104.14690.pdf ,可以閱讀我們研究論文的全部細節。
彌合策略建立和機器學習驅動的自動執行之間的差距
我們相信,隨著時間的推移,FSL 可以提高我們所有的完整性人工智慧系統的效能,讓它們利用單一的、共享的知識庫和主幹來處理許多不同型別的違規行為。但是,它也可以幫助人們在策略、標籤和調查工作流方面,彌補人類洞察力和分類器進步之間的差距。
FSL 可用來檢測出一組新的可能的策略違規行為,並理解所提出的定義的合理性和有效性。它投下了一張更廣泛的網,浮現出更多型別的“幾乎”內容違規,策略團隊在決定或制定訓練新分類器的註釋者,以及幫助保持我們平臺安全的人類審查員的規模指導時,應該瞭解這些內容。由於它擴充套件迅速,從策略制定到執行的時間將縮短几個數量級。
向能更有效學習的類人人工智慧邁進
能夠迅速開始對沒有大量標記的訓練資料的內容型別進行強制執行是向前邁出的一大步,這將有助於使我們的系統更加靈活,並對新出現的挑戰作出反應。
小樣本學習和零樣本學習是我們一直在進行重大研究投資的許多前沿人工智慧領域之一。而且我們沒有看到對生產管道的研究放緩的跡象。我們正致力於一些重要的開放研究,這些研究問題不僅要了解內容,還要從文化、行為和對話環境中推理。
雖然還需要完成大量的工作,但是,這些初期的生產成果已經成為了一個具有里程碑意義的標誌,它將會向一個更智慧、更通用的人工智慧系統過渡,能夠在同一時間內完成多種任務。
我們的長遠目標是,實現類似人類的學習靈活性和效率性,讓我們的完整性系統更快、更容易訓練,並能更好地處理新資訊。像 Few-Shot Learner 這樣的可教人工智慧系統可以大幅提高我們檢測和適應新情況的能力的敏捷性。透過更快、更準確地識別不斷演變的有害內容,FSL 有望成為一項關鍵的技術,幫助我們繼續發展和解決我們平臺上的有害內容。
原文連結:
https://ai.facebook.com/blog/harmful-content-can-evolve-quickly-our-new-ai-system-adapts-to-tackle-it